企业AI知识库
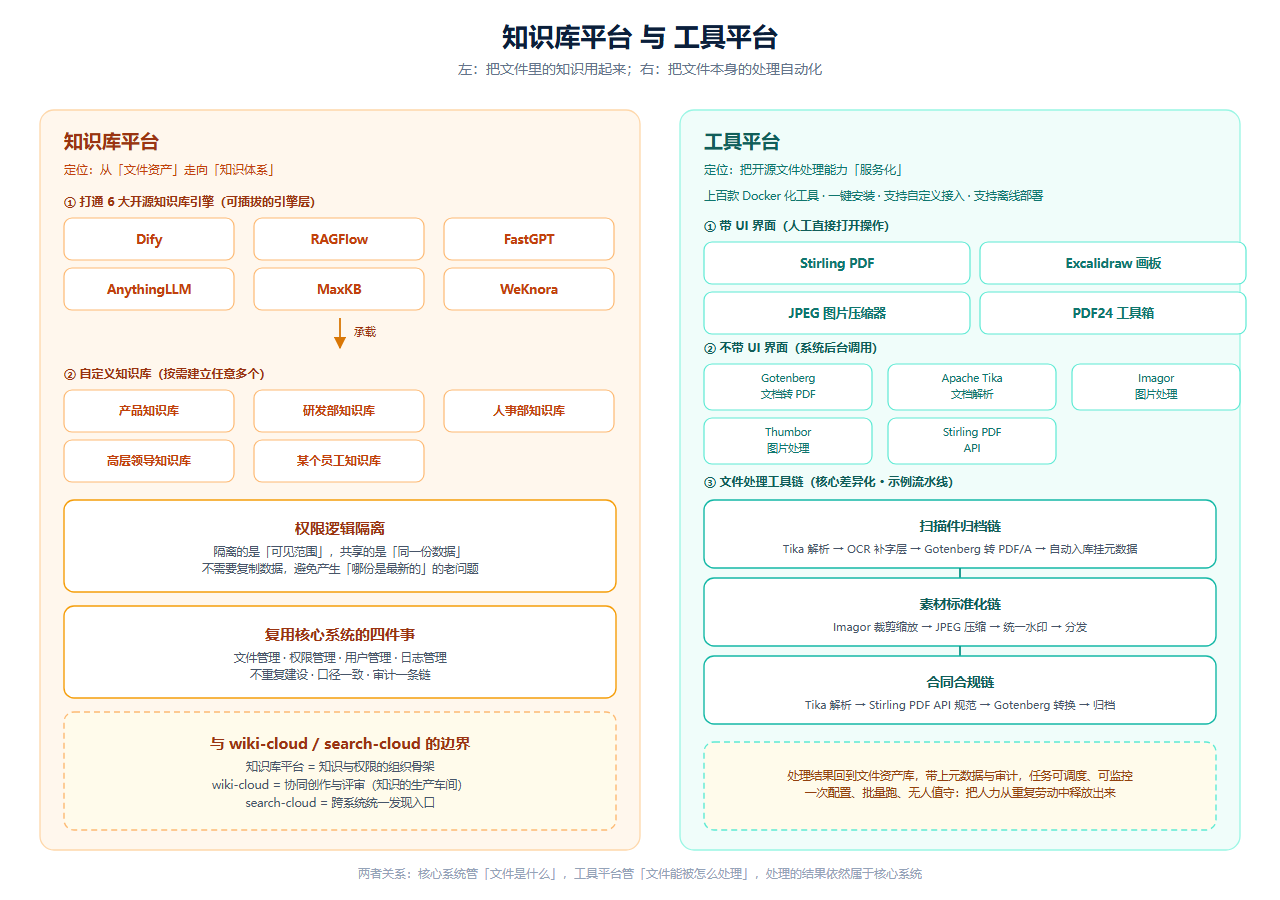
在佑桥核心系统之上,按需建立任意多个知识库——每个知识库自定义纳入团队与人员,权限逻辑隔离; 底层打通 Dify、RAGFlow、FastGPT、AnythingLLM、MaxKB、WeKnora 六大开源知识库引擎; 文件、权限、用户、日志四件事,全部复用底座,不重复建设。
知识库是什么:从文件资产,到知识资产
先把一个常见误区讲清楚,再看佑桥是怎么做的。
光有文件库,并不等于有了知识
一个常见的误区是:以为把文件管好了,知识自然就管好了。事实并非如此。
文件是"物理单位",知识是"逻辑单位"。一份《产品路线图》是一个文件;而"我们明年主攻哪个市场"这个知识, 可能散落在路线图、季度总结、评审纪要等十几个文件里。文件库再整齐,如果没有人把这些分散的内容组织成 "一个团队能共同查阅、共同维护的知识",知识就依然是沉睡的。
- 文件资产解决的是"存得下、管得住、找得到"
- 知识资产解决的是"说得清、问得着、用得上"
- 知识库还有一个现实价值:它是让 AI 真正好用的前提——没有经过组织的知识,AI 只能在碎片里拼凑;有了知识库,AI 才能站在一个清晰、可信、有来源的知识底座上回答问题
"自定义知识库"是什么意思
知识库不是系统预置好的几个,而是可以由组织按需建立的任意多个。
- 怎么建:为每个知识主题建一个知识库实例,建的时候回答两件事——这个知识库叫什么、它服务于谁
- 谁能进:每个知识库都可以自定义纳入不同的团队和人员。产品知识库可以纳入产品部全员,高层领导知识库可能只纳入核心管理层,某个员工知识库则可能只服务那一个人
- 权限怎么隔离:佑桥所说的隔离是"逻辑隔离"——数据放在一起,但通过权限规则让不同的人只能看到自己该看的部分
- 为什么不用物理隔离:物理隔离要在多处复制同样的文件,复制之后又会产生"哪份是最新的"的老问题;逻辑隔离下基础文件只存一份,被多个知识库引用,权限各管各的——隔离的是可见范围,共享的是同一份数据
知识库权限逻辑隔离示意(同一个底座,不同的可见范围)
维护人:产品经理
维护人:技术负责人
维护人:HR
维护人:管理层办公室
维护人:该员工
知识库平台与工具平台,共用同一套底座
知识库不是另一套系统:它复用核心系统的文件、权限、用户与日志;工具平台同理,处理完的结果回流同一条资产链路。
RAG 智能检索:两种"搜",解决两类"搜不到"
佑桥的检索由两个引擎共同支撑:一个负责"关键词对得上",一个负责"意思对得上"。
全文检索
关键词匹配对文件正文建立索引,按关键词精确命中。它的逻辑是"你在正文里出现了这个词,我就能找到你"。 它精确、可预期,适合心里已经知道要搜哪个词的场景。
向量检索(语义检索)
语义匹配把内容表达成向量,比较语义上的接近程度。它的逻辑是"你表达的意思和我表达的意思接近,我就能找到你"。 它更宽容、更懂人话,适合记不清原文用了哪个词、但知道想找什么的场景。
六大开源引擎对接:打通生态,而不是重复造轮子
佑桥不从零自研知识库引擎,而是把上面那些自定义知识库,对接到底层不同的开源引擎上——用哪个引擎承载哪个知识库,由你决定。
Dify
- 定位
- 偏向 AI 应用开发与编排,社区活跃、上手门槛较低。
- 适合什么知识库
- 希望自己动手把知识库和 AI 应用组合起来的团队。典型搭配:产品知识库、面向外部服务的问答类知识库。
RAGFlow
- 定位
- 在文档解析与检索增强(RAG)这条路上做得较深,复杂文档的解析能力是其特点。
- 适合什么知识库
- 文档结构复杂、对检索质量要求高的团队。典型搭配:制度规范库、技术文档库。
FastGPT
- 定位
- 以快速搭建问答式知识应用见长,配置简洁。
- 适合什么知识库
- 希望快速上线"问知识库"能力的团队。典型搭配:客服知识库、常见问题库。
AnythingLLM
- 定位
- 偏向个人与团队的本地化知识助手,部署轻量。
- 适合什么知识库
- 对数据本地化有偏好、希望快速试点的团队。典型搭配:个人知识库、小团队资料库。
MaxKB
- 定位
- 偏向企业级知识库问答,强调易用与企业场景适配。
- 适合什么知识库
- 希望开箱即用、由 IT 统一维护的团队。典型搭配:人事部知识库、综合制度库。
WeKnora
- 定位
- 面向知识抽取与结构化,把零散内容整理成更结构化的知识。
- 适合什么知识库
- 希望进一步结构化、形成知识图谱类能力的团队。典型搭配:研发部知识库、专业领域知识库。
尊重组织的既有选择
很多组织在引入佑桥之前,已经在用某个开源知识库,或者有自己偏好的技术路线。打通生态意味着:不必为了用佑桥而放弃已有的技术积累。
让专业的人做专业的事
知识库引擎是一个高速演进的领域,开源社区在这个方向上的迭代速度很快。与其自研一个可能很快落后的引擎,不如把组织接入到活跃的生态里。
避免被单一路线绑定
打通多个引擎,客户在引擎层面保留选择权与迁移可能。今天用哪个、明天换哪个,知识库本身不用推倒重来。
知识库怎么建:五步跑通一个库
不要一上来就建一个"公司大知识库"。从一个团队、一个主题、一个明确的维护人开始,跑通之后再复制到其他团队。
定范围
先回答三件事:这个库建给谁、放什么内容、谁来维护。范围越小越具体,越容易活下来。
选引擎
按这个库的特点选底层引擎:偏问答用 FastGPT,文档解析要求高用 RAGFlow,要多引擎并存也可以。
定权限
自定义纳入团队与人员,权限逻辑隔离。该共享的共享,该限制的限制——高层库与个人库的权限策略应当不同。
灌文件
文件不需要"搬"进来——知识库直接复用底座的文件管理;日常由智能体同步与 PC 端同步工具持续补充。
用起来
从"能搜到"到"能问到":先用全文检索确认,再用语义检索兜底,让新人也能自己找到答案。
从小而具体开始
不要期望所有人都往一个"公司大知识库"里放东西。先跑通一个团队、一个主题,再复制经验到其他团队。
明确"谁维护"比"放什么"更重要
知识库最大的风险不是内容少,而是没人维护、逐渐过期。每个知识库都必须有一个明确的责任人。
善用权限逻辑隔离
高管库、个人库与公开库的权限策略应当不同;即使是个人知识库,也在组织的治理体系之内——员工在职时方便自己,离职时资料不会跟着消失。
五个常见知识库:建给谁、放什么、谁维护
| 知识库 | 建给谁 | 放什么 | 谁维护 |
|---|---|---|---|
| 产品知识库 | 产品与售前团队 | 产品资料、需求文档、竞品分析、销售话术、常见问题、演示素材 | 产品经理主维护,售前团队补充 |
| 研发部知识库 | 研发团队 | 技术方案、接口文档、代码规范、故障复盘、部署手册 | 技术负责人主维护,工程师按模块补充 |
| 人事部知识库 | 全体员工与 HR | 规章制度、考勤与休假办法、福利政策、入职指南、常见人事问答 | HR 主维护 |
| 高层领导知识库 | 核心管理层 | 战略规划、经营分析、董事会材料、重要决策记录 | 管理层办公室主维护 |
| 某个员工知识库 | 单个员工 | 个人工作笔记、资料沉淀、待办与研究材料 | 该员工自己 |
与 wiki / search 子系统的边界:组织、生产、发现
应用平台里有两款子系统与知识库平台关系密切,三者互补而不是替代。
知识库平台
解决"知识以什么单位被组织、被授权、被隔离",提供知识与权限的组织骨架。这一层决定谁能看到哪一部分。
wiki-cloud
解决"知识怎么被协同地写出来、改出来、评审出来"。词条协同编辑、版本只追加、评审台、知识地图、带溯源的 AI 问答——它更像知识的生产车间。
search-cloud
解决"知识怎么被找到"。作为统一搜索入口与知识门户,把散落在各个系统里的内容统一索引,用一套搜索框找到所有东西。
wiki-cloud 在上面提供"协同创作与评审能力",
search-cloud 提供"跨系统的统一发现入口"。一个组织可以只装其中一部分,也可以全部装上——缺哪个补哪个,不必推倒重来。
四件事全部复用底座,不重复建设
知识库平台有一条设计原则:文件管理、权限管理、用户管理、日志管理,四件事全部复用佑桥核心系统。
文件管理
知识库里的文件,用的就是核心系统的文件能力——同一套上传、预览、版本、检索、分享。知识库不需要再建一套文件系统,也不需要把文件"搬"进来。
权限管理
知识库的访问权限,用的就是核心系统的 RBAC 权限体系。不需要为知识库单独发明一套权限模型,组织的权限规则在哪儿配置,知识库就跟着生效。
用户管理
知识库的成员,用的就是核心系统的用户与组织。钉钉 / 企业微信 / 飞书里是谁,知识库里就是谁,不需要单独维护一份成员名单。
日志管理
知识库的操作日志,用的就是核心系统的审计能力。谁在什么时候看了、改了、导出了哪条知识,进入的是同一条审计链路。
不重复建设
不需要为知识库单独采购一套文件系统、单独配置一套权限、单独维护一份用户名单,已有的投入直接复用。
口径一致
文件、权限、用户的口径在底座与知识库之间是同一个,不会出现"同一个人在两个地方权限不一样""同一份文件在两个地方版本不一样"的错乱。
审计一条链
所有操作记录汇聚到同一条审计链路上。要查一件事,不需要在多个系统里分别查、再拼起来。
先建一个库,跑起来再说
我们可以按你所在的团队,演示从一个主题的建库、授权到检索问答的完整过程,约 30 分钟。